有人说 API 很慢,房间里立刻就冒出六种解决方案:加 Redis、加索引、加服务器、重写端点、把所有事情并行化,或者怪网络,祈祷没人追问。
与此同时,我们仍然没有解释时间都花到哪里去了。
我喜欢从一个小得多的起点开始。给我一个慢请求、我们计时的边界,以及足够解释其耗时的证据。然后我们就能有效地讨论该改什么。
针对这个原创的后端面试练习,设想有一个商品详情 API,从请求到达网关到响应完成共耗时 900 毫秒。它的 SQL 查询耗时 40 毫秒。这些数字是合成的示例数据,并非生产事故,也不代表对任何特定公司的描述。
我们的任务是在改善体验的同时,避免无意中降低答案的正确性。更快地返回错误价格,可不是我们想要的小胜利。
首先,明确测量从哪里开始、到哪里结束。从浏览器点击到屏幕可用、从请求到达网关到响应完成,以及数据库查询执行,是不同的时间区间。
在我们的例子中,计时范围是服务器处理路径:从网关收到请求开始,到响应在网关处完成为止。目前我们还没有测量 DNS、请求到达前的连接建立、返回浏览器的网络传输,或客户端的渲染时间。
这个边界很重要,因为一条再漂亮的服务器跟踪记录,也解释不了它从未测量过的时间。
接下来,把笼统的抱怨具体化。这是某一条路由、某个区域、某个租户的问题,还是每个请求都如此?变慢是在部署之后开始的、只在繁忙时段出现,还是只影响响应特别大的请求?把成功请求和失败请求分开比较,避免快速失败让服务看起来快得令人安心。
Google 的 SRE 指南关于分布式系统监控的内容强调,除了延迟,还要关注流量、错误和饱和度。这些信号能帮助我们在选择补救措施前描述清楚症状。
在这个练习中,先从一个成功但缓慢的请求入手。把它当作调查线索,而不是所有用户都遇到相同问题的证明。
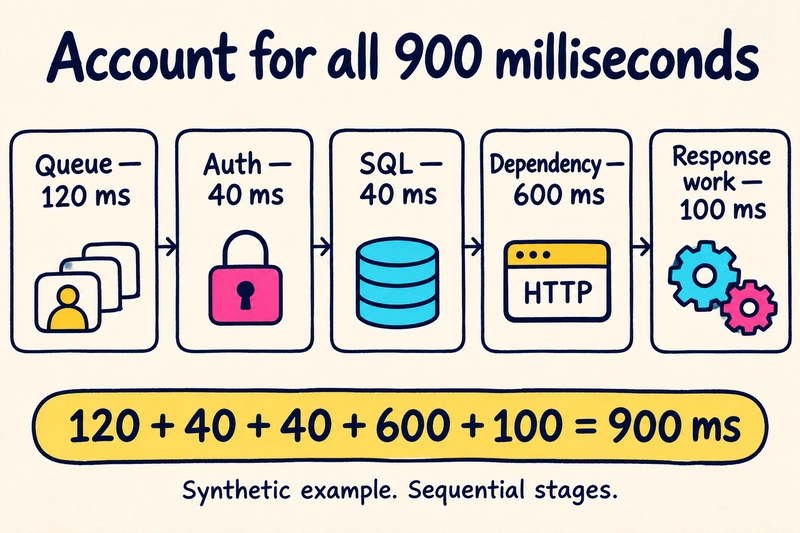
设想我们的监测数据提供了以下互不重叠的阶段。在这个特意简化的示例中,各阶段依次发生。
- 请求等待 120 ms 后,应用工作线程才开始处理。
- 身份验证耗时 40 ms。
- SQL 查询耗时 40 ms。
- 一个出站依赖调用耗时 600 ms,这是从我们的服务观察到的时间。
- 序列化和响应完成耗时剩余的 100 ms。
这些阶段加起来共 900 ms。我们假设测量包含排队时间,并且没有遗漏相关区间。
如果你的真实跟踪记录加起来对不上,别急着把缺失的时间归为网络开销,然后就此打住。它可能来自未监测到的工作、跨度之间的空档,或你对测量边界的误解。
OpenTelemetry 对跟踪和跨度的说明在这里很有用。一条跟踪记录会把一次请求中的多个操作关联起来,而跨度则记录单个操作的耗时和上下文。这种结构能帮你追问请求经过了哪些地方,但无法揭示从未监测到的工作。
还要确认这 600 ms 实际测量的是什么。一个 HTTP 客户端跨度可能包含获取连接、建立连接、等待远程服务以及接收其响应所花的时间。这能证明该区间耗时很高,却不能证明远程应用花了 600 ms 在计算。
说实话,调查到这里才开始变得有意思。我们已经缩小了排查范围,同时没有假装自己已经知道答案。
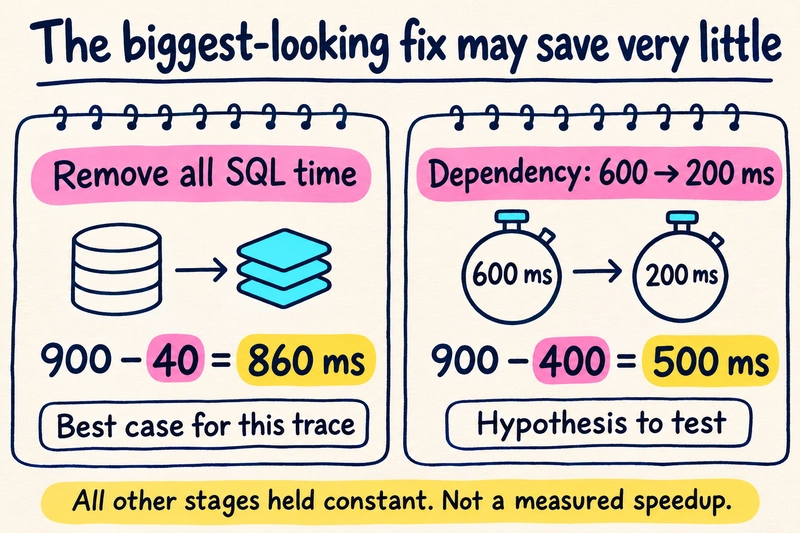
假设第一个建议是缓存 SQL 查询结果。即使缓存能以零额外开销消除整个 40 ms 查询,在这条固定的跟踪时间线上,总耗时仍会是 860 ms。
在这个例子中,其他阶段都保持不变时,最多只能节省约 4.4%。这不是对真实缓存性能的预测,也还没有涉及缓存未命中、失效或数据新鲜度问题。
相比之下,如果把依赖调用的时间从 600 ms 降到 200 ms,同一条简化时间线的总耗时就会变成 500 ms。这个假设值得调查,因为潜在影响大得多。
这并不意味着缓存总是错误的答案。在负载下,减少数据库工作可能会降低争用,也缩短其他等待时间。我们对单个请求的计算刻意将这些影响保持不变,因此负载测试可能会得出不同结果。
这项计算能帮我们提出一个严谨的问题:是什么机制让这项改动减少了我们实际观察到的延迟?如果该机制确实起作用,改进幅度可能有多大?
我更愿意先回答这个问题,再引入另一个我们需要运维的服务。
把这 600 ms 的依赖调用拆开,逐一调查几种可能性。也许本地客户端在等待连接。也许连接建立很慢。也许远程服务很慢。也许大响应需要较长时间才能传完。
每种解释都需要不同的证据,也指向不同的改动。
例如,如果主要耗时在获取连接,就检查连接池占用率、待处理请求数和连接生命周期。增大连接池只是一个提议;它可能压垮下游服务,也可能只是把队列挪到别处。
如果主要耗时在远程处理,而下游跟踪记录可用,就把出站请求与它关联起来。如果主要耗时在传输响应,就检查响应大小,以及调用方是否需要所有字段。把缺失的证据明确标出来,不要把看似合理的解释当成事实。
对应用工作线程启动前的这 120 ms,也要做同样的调查。CPU 使用率低,并不能排除某种受限资源导致的等待。另一方面,单个排队请求也不能证明服务需要更多工作线程。
下一次测量应能区分彼此竞争的解释。多贴十张都显示“慢”的仪表盘截图,并不等于找到了更明确的原因。
现在修改一下例子。假设两个彼此独立的下游调用同时开始,一个耗时 400 ms,另一个耗时 300 ms。响应需要两者的结果,随后还要进行 100 ms 的响应处理。
忽略其他开销,耗时是 500 ms,因为响应要等较慢的分支完成,然后再完成自身的处理。把 400、300 和 100 相加得出 800 ms,会重复计算重叠的时间。
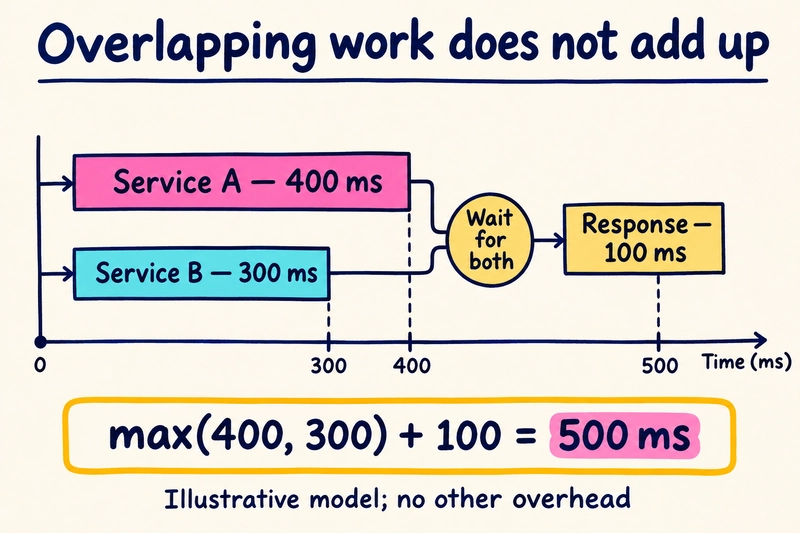
这也会改变哪项优化更重要。只要 400 ms 的分支仍然决定汇合时间,把 300 ms 的分支缩短到 100 ms,就不会缩短这次响应时间。它或许能降低资源使用量,但那是另一种主张。
在并行化真实调用之前,先确认它们互不依赖对方的结果,并确认并发执行不会破坏顺序要求,也不会使共享依赖过载。并行是一种调度决策,并不意味着在所有情况下都会更快。
把请求时间线看作一组依赖关系。找出决定响应何时能完成的那条链,并避免把已包含在子跨度中的父跨度耗时再次相加。
针对我们的合成请求,一条有用的调查记录可以写明:依赖调用区间为 600 ms,连接池等待是一个可能的解释,下一步需要获取连接耗时的证据。这样,其他人就能质疑并复现这项调查计划。
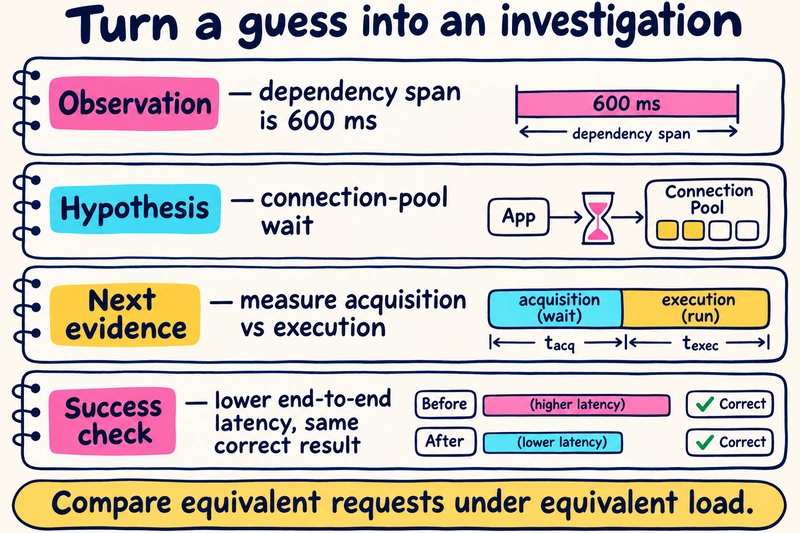
有证据支持某项改动后,要在条件相当的情况下比较同类请求。明确路由、负载内容、授权上下文、数据形态和负载特征。若冷启动和热运行表现不同,就分别记录。
检查端到端延迟,同时关注错误、正确性、完成的吞吐量以及你改动的资源。比较时也要纳入慢请求,不能只看平均值,并记录样本量和测量时段。平均表现有所改善,可能掩盖了少数用户体验变差的情况。
如果补丁通过跳过必需工作来提前返回,那是行为变更,不是免费的优化。如果产品接受部分响应或陈旧数据,就明确说明这一约定并进行测试。
再练习一轮时,可以用这个购物车延迟问题。提出改进方案前,先画出现有的请求路径,然后找出哪些工作必须完成,用户才能看到正确的购物车。库存数据的新鲜度也是必须保留的结果之一。
继续之前,给自己留一份简短的调查记录,写明测量边界、观察到的时间线、一个假设、下一步需要的证据,以及怎样的结果才算成功。
这就是我想练习的面试回答。当然可以讨论缓存和索引,但首先要让这份抱怨里的每一毫秒都在纸面上有据可查。
~ Emily