研究论文是研究成果糟糕的界面。
读读 AlphaGenome 论文——那篇关于预测变异效应的论文——再试着用用它。你得克隆一个代码仓库,花一下午折腾依赖版本,猜哪个 notebook 单元格才装着真正的方法,还要把图表里的内容手动换算成数字。论文描述了科学研究,却不肯亲自做科学研究。
斯坦福大学团队——Jiacheng Miao、Joe R. Davis、Yaohui Zhang、Jonathan K. Pritchard 和 James Zou——于**2026年9月16日发表于《Nature》**的论文中提出了解决方案:Paper2Agent,一条自动化流水线,可将研究论文转换为 MCP 代理,按需重新运行论文自身的方法。你用英语提问。它调用经过验证的工具。你得到答案,以及生成答案的代码。
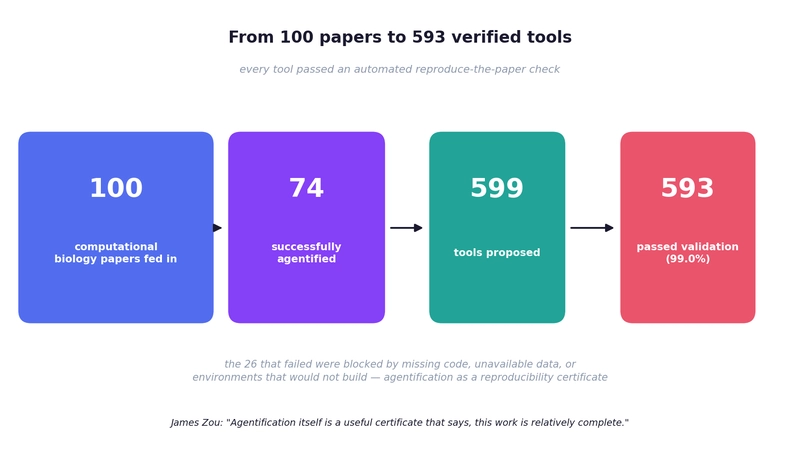
最受关注的一次运行:输入100篇计算生物学论文,74篇被转换为可用代理,提取出599个工具,其中593个通过自动验证。在300道基准问题上,这些代理也胜过显而易见的替代方案——直接把相同的代码仓库交给 Claude——得分为91.2%对82.7%。
论文像一本食谱:列出食材,描述步骤,还附上一张成品照片。每位读者都得从头重搭厨房——烤箱各不相同、香料缺这少那,有一步作者忘了写。结果有一半时候晚餐做砸了,还没人知道原因。
Paper2Agent 把食谱变成一个能和你对话的厨师。“帮我预测这个突变的变异效应。”厨师不会总结菜谱——它会开火做菜,把菜端给你,并展示它实际遵循的步骤,且这些步骤已对照原始照片验证。
关键见解是:读过代码仓库的 LLM,不如能够调用仓库中经过验证的函数的 LLM 更像一位出色的科学家。阅读会含糊。调用则精确。
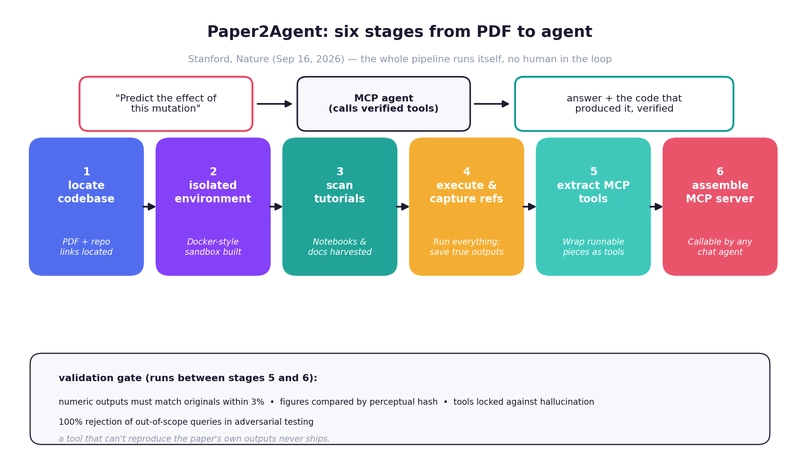
Paper2Agent 会接手论文,并自行完成所有令人头疼的设置工作:
找到代码库——找出代码仓库、notebook,以及论文中链接的文档。 2. 构建隔离环境——创建沙盒,在其中安装并锁定依赖项。 3. 扫描教程——收集展示方法实际用法的 notebook 和文档。 4. 执行并捕获结果——运行所有内容;将真实输出保存为基准事实。 5. 提取 MCP 工具——将可运行部分封装成带有 JSON schema 的参数化工具。 6. 组装 MCP 服务器——构建一个任何聊天代理都能用自然语言调用的模型上下文协议服务器。
第5和第6阶段之间的验证关卡是成败关键:数值输出必须与论文自身结果相差不超过3%,生成的图像通过感知哈希进行比较,工具会被锁定,以防模型即兴改变行为;对抗性测试表明,系统对范围外查询的正确拒绝率达到100%。无法复现论文自身输出的工具绝不会发布。
正是这次规模化运行,让这项工作成为《Nature》论文,而非演示:
**100篇论文——74个代理。**有26篇因代码缺失、数据不可用或环境无法构建而未能转换。James Zou 如此描述:*“代理化本身是一种有用的证明,说明‘这项工作相对完整’。”*这条流水线也兼作可复现性审计。
**提出599个工具——593个通过验证(99.0%)。**有6个工具未通过复现论文的关卡——这恰恰说明关卡发挥了应有作用。
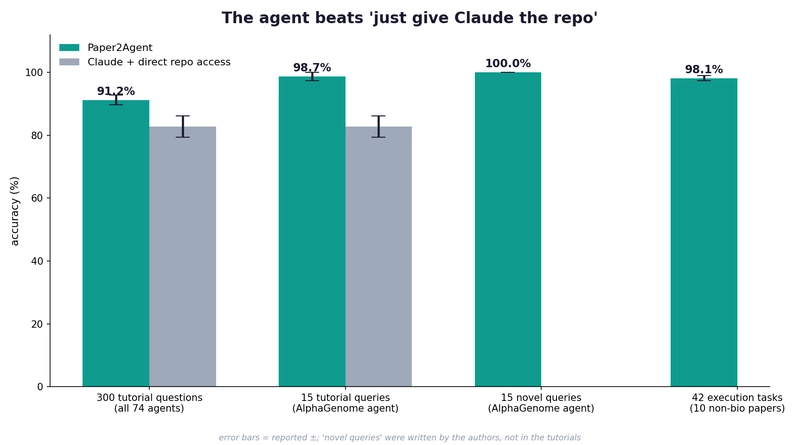
在74个代理的300道教程衍生问题上,得分为91.2 ± 1.6% 对 82.7 ± 3.4%。知识相同,模型系列相同——差别在于封装方式:可调用工具胜过一堆文件。
具体来看 AlphaGenome 代理:约45分钟、约14美元的计算成本,构建出22个工具。在15道教程查询上的得分为98.7 ± 1.3%;在作者自行编写的15道新查询上(教程中没有),得分为100%。
生物学以外的领域:来自10篇非生物学计算论文的42项执行任务达到98.1 ± 0.8%;运行时间中位数比 Claude 加代码仓库快1.9倍,比 Biomni快3.1倍。
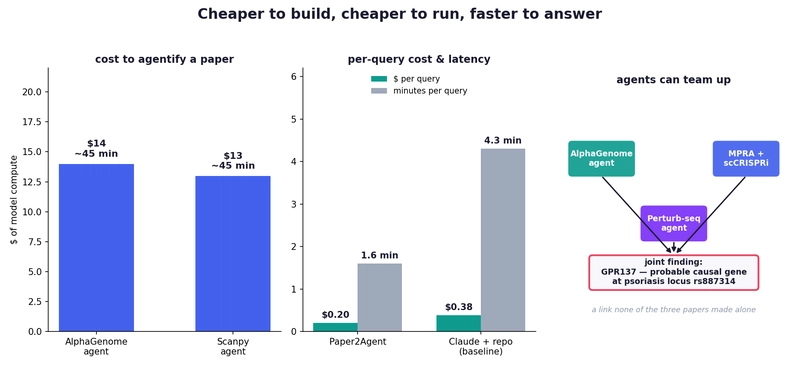
成本:将一篇论文代理化需14美元、约45分钟。每次查询:0.20美元对0.38美元(基线),延迟为1.6分钟对4.3分钟。
一个代理回答问题,只是更好的搜索引擎。三个代理协作则是另一种新东西。
作者基于三篇互不相关的论文构建了代理——一个 AlphaGenome 变异效应代理、一个与 MPRA 联合的 scCRISPRi 筛选代理,以及一个 CD4+ T 细胞 Perturb-seq 代理——并让它们将计算预测与实验筛选串联起来。它们共同将GPR137 列为银屑病相关位点 rs887314 处的一个可能致病基因。这三篇论文中,没有一篇单独得出这一关联。
斯坦福医学院另有一项演示:来自两项互不相关研究的两个代理(一个突变预测工具和一项 ADHD 全基因组关联研究)发现了一个此前未有报告的、靠近MPHOSPH9的变异,该变异与 ADHD 风险升高有关。Zou 展望的是:“数百万论文代理大规模发现彼此重叠的研究”——让原本不会相遇的研究相互配对。他直言不讳地谈到成果归属问题:发现仍归于原论文及其人类作者。
论文没有淡化这些问题,我也不会:
**26%的论文无法转换。**代码缺失、数据缺失、环境无法构建。这是披着成功指标外衣的可复现性丑闻——作者对此心知肚明。 2. **科学研究仍由人类主导。**开放式假设选择和证据评估仍由人在环路中完成。代理会重新运行并应用方法,但不会决定什么才重要。 3. **每个代理都会过时。**以这种方式构建的 MCP 服务器需要持续维护,因为上游依赖项会变化。论文代理是需要维护成本的活产物,而不是存档后就不再过问的 PDF。 4. **关于“新查询”的说明。**新查询得分100%的结果,依据的是作者编写的15道问题。真正的考验将是独立基准测试。
外部人士对此感兴趣,但也有所保留——这才是恰当的态度。威尔康奈尔医学院的 Olivier Elemento 称之为:“我们思考出版流程方式上的一项真正进步,人工智能处于核心位置。”马里兰大学的 Dongping Chen 称可执行论文“相当有说服力”。目前没人声称它能取代同行评审。
**论文正在变成 API。**Paper2Agent 的主张是:知识应以可运行、经过验证的工具形式发布,而非静态文本。74篇论文、593个工具、99%的验证通过率。 2. **结构胜过访问方式。**模型相同,代码仓库相同:以可调用工具形式提供时得分为91.2%,以文件形式提供时为82.7%。知识的封装方式如今已成为影响性能的关键因素。 3. **验证才是核心产品。**3%容差的论文复现关卡,加上工具锁定,才让系统值得信赖。把代码封装成 JSON-RPC 很简单;证明封装后的工具能复现科学研究才是这项工作的贡献。 4. **代理可以组合。**三个论文代理在 rs887314 位点发现了 GPR137——三篇论文中没有一篇单独做到这一点。论文代理网络才是真正的最终目标。 5. **代理化是一种可复现性证明。**如果你的论文经不起这条流水线的检验,那本身就是关于这篇论文的信息。
来源:《Nature》(2026年9月16日)——《将研究论文重新构想为交互式可靠的 AI 代理》(Miao、Davis、Zhang、Pritchard、Zou);AI Weekly 报道(2026年9月24日);IEEE Spectrum;斯坦福医学院。数字均据作者报告。
**配套 notebook:**本文配套的可运行教程——在此下载(在 Colab/Jupyter 中打开)。