信息≠知识
收藏和转发只是获取,还没有形成自己的理解。
杨思远的 AI 实践与开源记录
AI·LAB / 信息沉淀系统
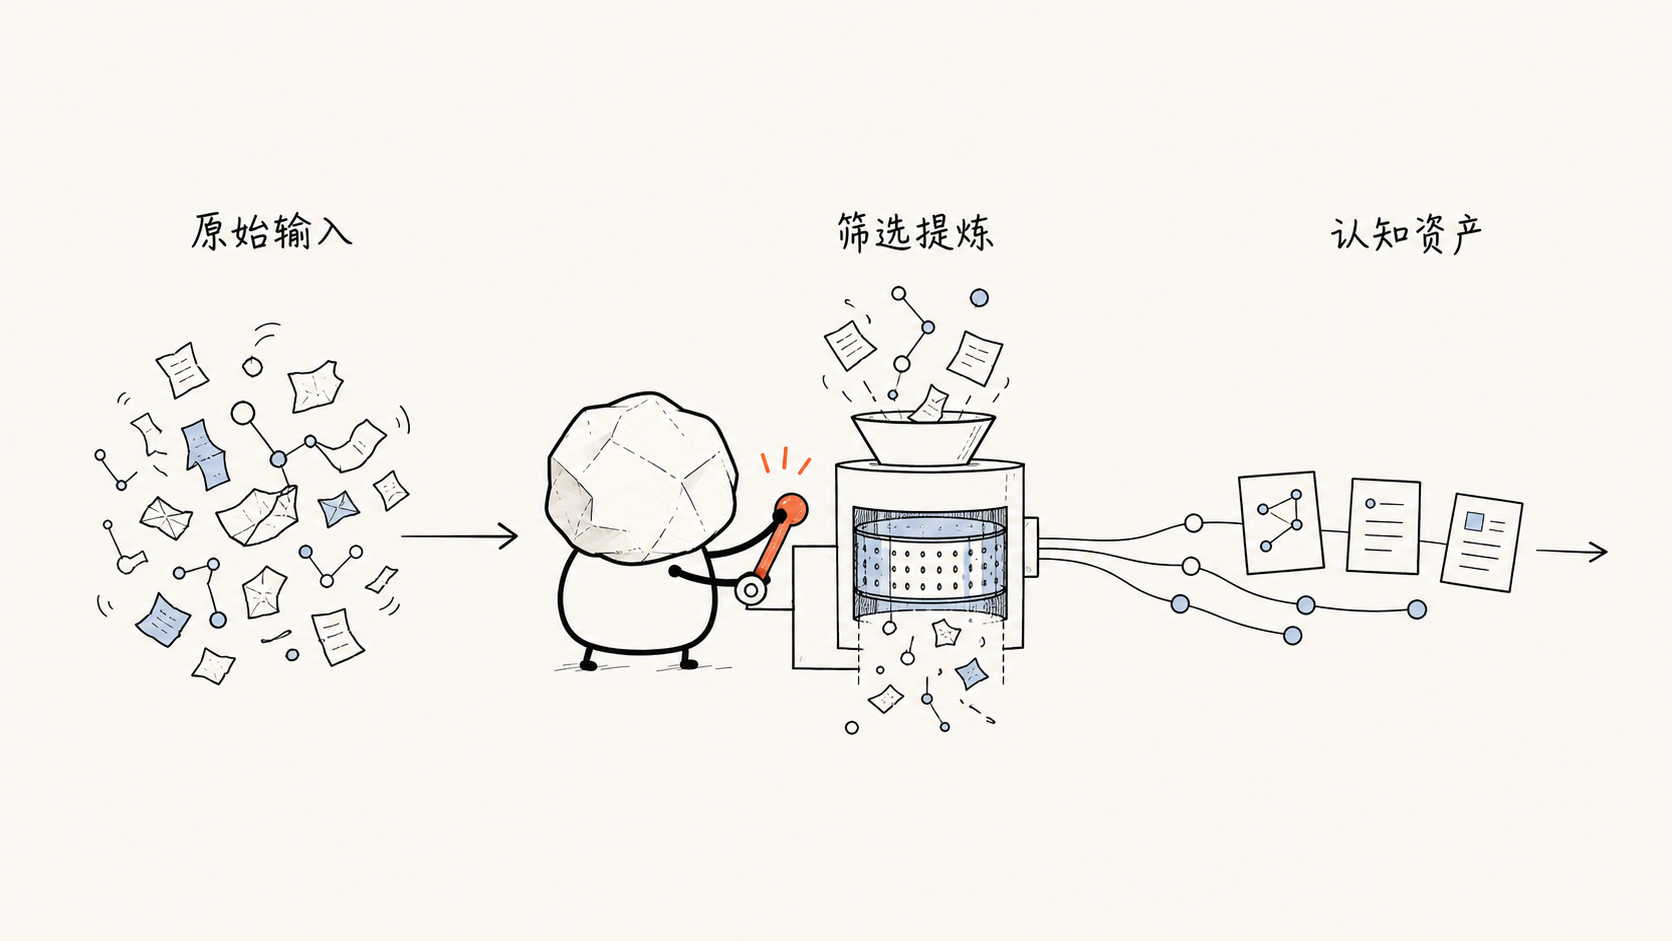
信息不是被收藏就变成知识。它要经过获取、过滤、加工、审阅与确认,才能成为可长期调用的认知资产。
收藏解决的是“以后可能会看”。知识系统解决的是“需要时能够准确找到、理解和调用”。
这套系统不追求存得更多。它先判断什么值得留下,再把经过确认的部分变成结构化知识。
核心理念
系统的价值不在于自动保存一切,而在于让每一步都有清楚的门槛。
信息≠知识
收藏和转发只是获取,还没有形成自己的理解。
加工≠沉淀
进入缓冲区只是等待处理,还不能成为长期记忆。
公开≠自动
进入公开层之前,必须经过脱敏、审阅和确认。
三种机制同时运转
获取、自动化和信息减法不是三个先后阶段。它们同时工作,但每一条具体信息仍要依次经过获取、筛选、审阅和入库门槛。
看到值得保留的内容,直接交给 AI 获取原文和来源。视频、文章、网页与零散笔记先集中进入待处理缓冲区。
解决的是:别让有价值的信息散落。系统提取信号、交叉验证、生成候选并给出置信度。异常或有冲突的内容进入审阅队列,最终由人决定。
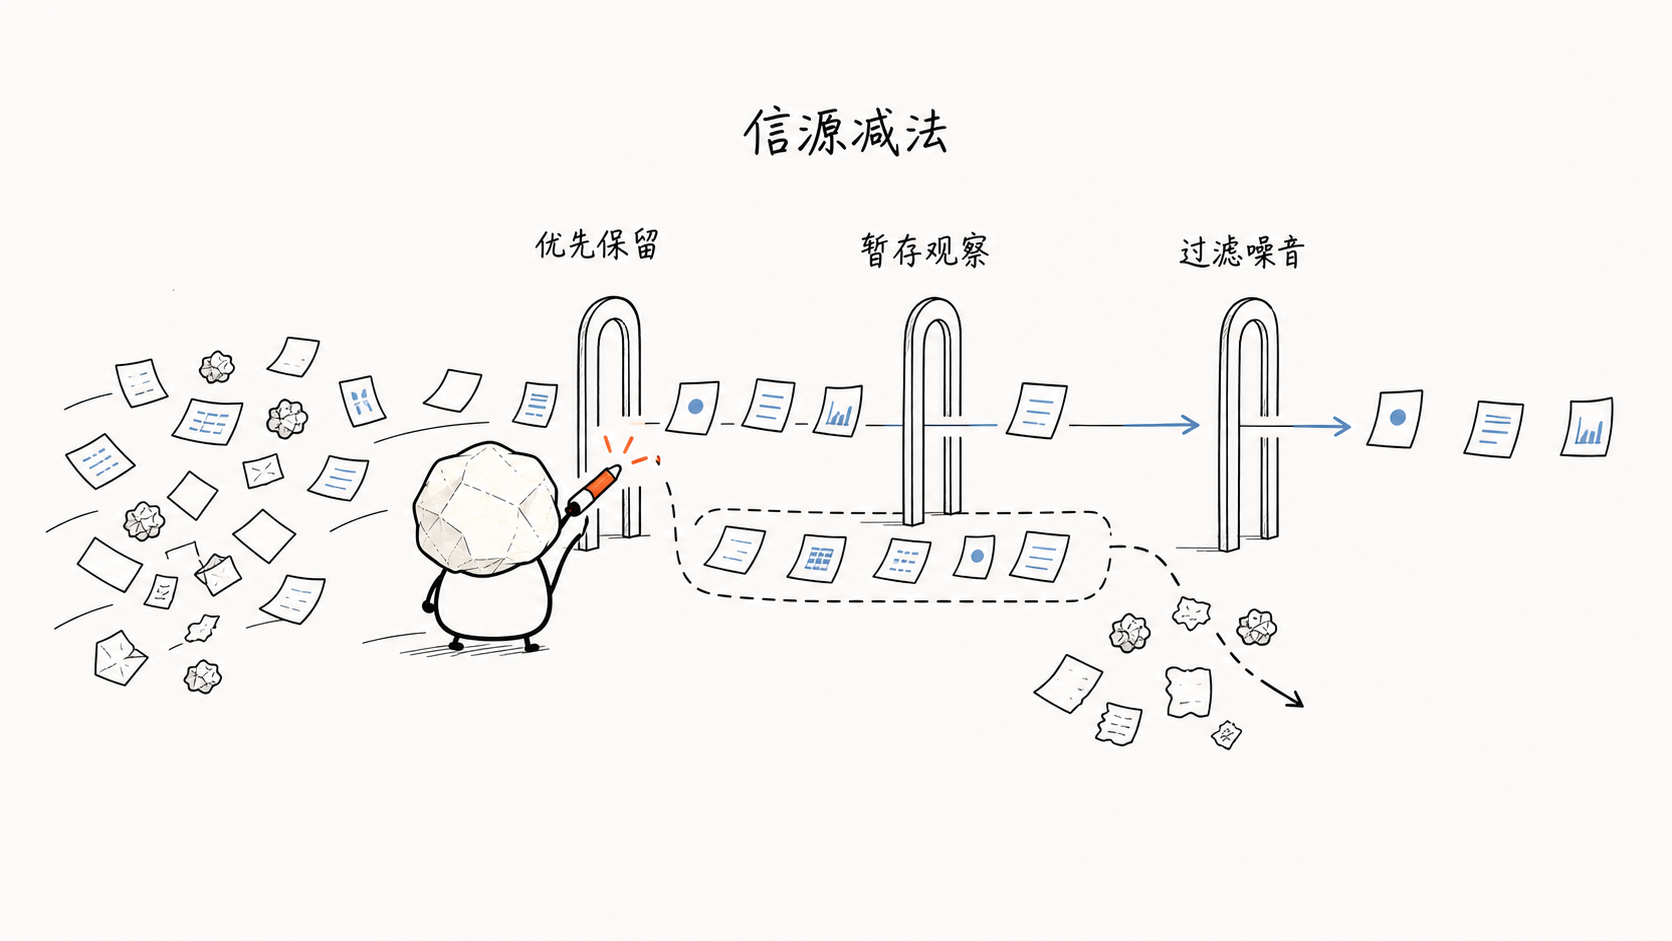
解决的是:人不必从头阅读每一条。优先保留权威、可追溯、长期有用的来源。社区讨论只用于观察,营销软文和重复内容不进入正式知识库。
解决的是:注意力不被低质量内容稀释。自动化负责缩小范围,人负责处理冲突、边界和最终落点。
信源减法
系统先建立来源原则,再决定抓什么。可追溯、长期有用的内容优先;仍需判断的内容暂存观察;明显噪音不进入知识库。
主动搜索与 Deep Research 属于规划能力,将在需要时按任务发起,不承诺自动常驻抓取。
知识结构
Front Matter 是卡片顶部的结构化说明。正文负责讲清概念,顶部字段负责标注类型、领域、层级、标签和来源。
脱敏示例 / 不对应真实路径或真实卡片
---
type: knowledge-card
domain: 公开示例领域
level: 核心概念
tags: [示例标签, 可复用]
source: 已脱敏公开来源
---置信度与审阅
置信度不是替人做决定的分数。它只帮助系统安排审阅顺序,最终仍要服从来源、证据和公开边界。
来源可靠、可验证、与现有知识一致
快速确认,或按已批准规则入库
新主题、有冲突,或需要补充语境
保留在审阅队列,由人决定更新、合并或延后
重复、不可追溯,或存在明显风险
不进入正式知识库
系统组成
系统由三部分组成。第一部分已经在日常运行,后两部分用于未来扩展,不把规划写成已经上线的能力。
把收藏、笔记与规模化输入转成候选卡片,经过筛选与审阅后进入正式知识库。
围绕真实问题拆解搜索方向,分派调研,形成报告,再提炼可复用的知识卡片。
推荐 Skill:Deep Research(待接入)
从私有知识库中挑选适合公开的内容,完成脱敏和人工确认后,持续更新到独立站。
公开出口:AI 外脑(待接入)
产出总图
单条内容只有走完门槛路径,才可能成为正式知识。公开内容则在正式知识之上,再多一道脱敏与确认。
集中暂存原始输入,保留来源和最初问题。
提取信号,形成知识卡片候选和可参考资料。
根据来源、证据、置信度和适用边界决定去向。
Front Matter 加 Markdown 卡片,持续连接、修订和调用。
只呈现经过脱敏、审阅和人工确认的公开子集。
结论
它需要获取、过滤、加工、审阅与确认的闭环,才能从噪音里长出可复用的认知网络。